EVO-X2 128GB(Strix Halo)、Ubuntu24.04環境。個人的な主義としてDockerで動かしてる。
日記の方で雑にMTPを動かして早くなったねーというところまでは行けてたんだけど、Codex[cli/app]で動かすまでに意外と手がかかったので共有。
Docker ComposeでVllmでgemma4 MTPを動かす
モデルファイルをダウンロードする関係で、あらかじめ.envファイルにHuggingfaceのアカウントのトークンを設定しておく。
.env
HF_TOKEN=hf_xxxxxxxxxxxxxxx
docker-compose.ymlとして以下を設定。
services:
  vllm-gemma:
    image: vllm/vllm-openai-rocm:nightly
    container_name: vllm-gemma4-31b-mtp
    restart: unless-stopped
    ports:
      - "8000:8000"
    environment:
      - HSA_OVERRIDE_GFX_VERSION=11.5.1
      - HF_TOKEN=${HF_TOKEN}
    volumes:
      - ~/.cache/huggingface:/root/.cache/huggingface
      - /dev/kfd:/dev/kfd
      - /dev/dri:/dev/dri
    devices:
      - /dev/kfd
      - /dev/dri
    group_add:
      - video
      - render
    privileged: true
    shm_size: '16gb'
    entrypoint: ["python3", "-m", "vllm.entrypoints.openai.api_server"]
    command:
      - "--model"
      - "QuantTrio/gemma-4-31B-it-AWQ"
      - "--tokenizer"
      - "google/gemma-4-31b-it"
      - "--quantization"
      - "awq"
      - "--speculative-config"
      - "{\"model\": \"google/gemma-4-31b-it-assistant\", \"num_speculative_tokens\": 4}"
      - "--gpu-memory-utilization"
      - "0.7"
      - "--max-model-len"
      - "32768"                           # 256Kから現実的な32Kに変更
      - "--dtype"
      - "half"
      - "--enforce-eager"
      - "--served-model-name"
      - "gemma4:31b"
      - "--enable-auto-tool-choice"
      - "--tool-call-parser"
      - "gemma4"                          # gemma4専用パーサーを指定
      - "--host"
      - "0.0.0.0"
      - "--port"
      - "8000"
ポイントとしては
- 適度に量子化されてるモデルということでとりあえずQuantTrio/gemma-4-31B-it-AWQを使用、それに合わせ引数で量子化がawqであることを明記
- トークナイザをgoogle/gemma-4-31b-itと明示
- MTP Drafterを使うので--speculative-config引数でそのあたり指定
- --enforce-eagerは必要!
- --enable-auto-tool-choiceおよび--tool-call-parserも指定
という感じ。
あとはdocker compose up -dで立ち上げる。Ollamaとかllama.cppとかと比較すると起動には結構時間がかかるので、docker compose logs -fで待受状態になるのを見計らおう。気長に待てば、以下みたいな感じのメッセージが出るはず。
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [api_server.py:617] Starting vLLM server on http://0.0.0.0:8000
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:37] Available routes are:
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /openapi.json, Methods: GET, HEAD
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /docs, Methods: GET, HEAD
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /docs/oauth2-redirect, Methods: GET, HEAD
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /redoc, Methods: GET, HEAD
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /tokenize, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /detokenize, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /load, Methods: GET
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /version, Methods: GET
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /health, Methods: GET
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /metrics, Methods: GET
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/models, Methods: GET
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /ping, Methods: GET
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /ping, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /invocations, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/chat/completions, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/chat/completions/batch, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/responses, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/responses/{response_id}, Methods: GET
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/responses/{response_id}/cancel, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/completions, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/messages, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/messages/count_tokens, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /inference/v1/generate, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /scale_elastic_ep, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /is_scaling_elastic_ep, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /generative_scoring, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/chat/completions/render, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO 05-16 16:51:31 [launcher.py:46] Route: /v1/completions/render, Methods: POST
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO:     Started server process [1]
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO:     Waiting for application startup.
vllm-gemma4-31b-mtp  | (APIServer pid=1) INFO:     Application startup complete.
余談だけどvllmはllama.cpp系とは違って「もりもりリソースを使う代わりに早さを突き詰めよう」的な思想らしい。なるほどなあ。
Codexでの設定
codexはデスクトップアプリもCliも共通で~/.codex/config.tomlを参照するので、今回のサーバ情報を記載していく。
model = "gemma4:31b"
model_provider = "vllm"
profile = "vllm-gemma4"

[model_providers.vllm]
name = "vllm"
base_url = "http://[サーバのIPアドレス]:8000/v1"

[profiles.vllm-gemma4]
model = "gemma4:31b"
provider = "vllm"
personality = "pragmatic"
model_reasoning_effort = "low"
timeout = 1800
早くなったとはいえ、タイムアウトは長めにしておくの推奨。
これでcodex-cliの方を起動すると、下のようにgemma4:31bが使われてることが確認できる。
~ % codex
╭──────────────────────────────────────────────╮
│ >_ OpenAI Codex (v0.130.0)                   │
│                                              │
│ model:     gemma4:31b low   /model to change │
│ directory: ~                                 │
╰──────────────────────────────────────────────╯

  Tip: New Build faster with the Codex App. Run 'codex app' or visit https://chatgpt.com/codex?app-landing-page=true


› こんばんわ


⚠ Model metadata for `gemma4:31b` not found. Defaulting to fallback metadata; this can degrade performance and cause issues.

• こんばんは!何かお手伝いできることはありますか?


› Implement {feature}

  gemma4:31b low · ~
デスクトップアプリも設定を共有している・・・はずなんだけど、なんか妙なクセがある気がするんだよなあ。設定変更してもすぐにはうまく反映されない気がしている。
僕の中では、一回cliで触っておいてから起動すると安定して使える印象。
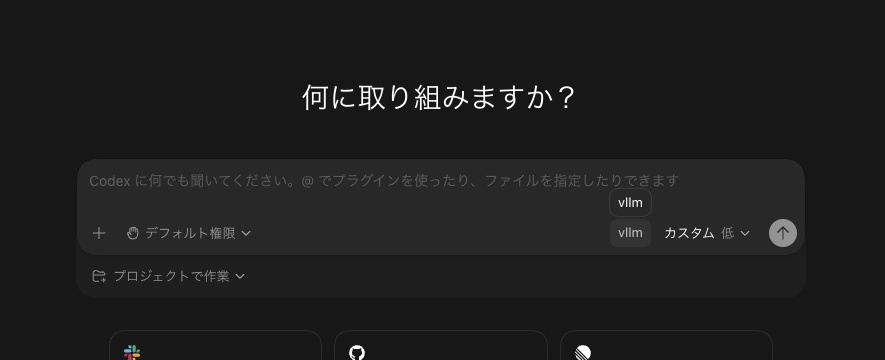
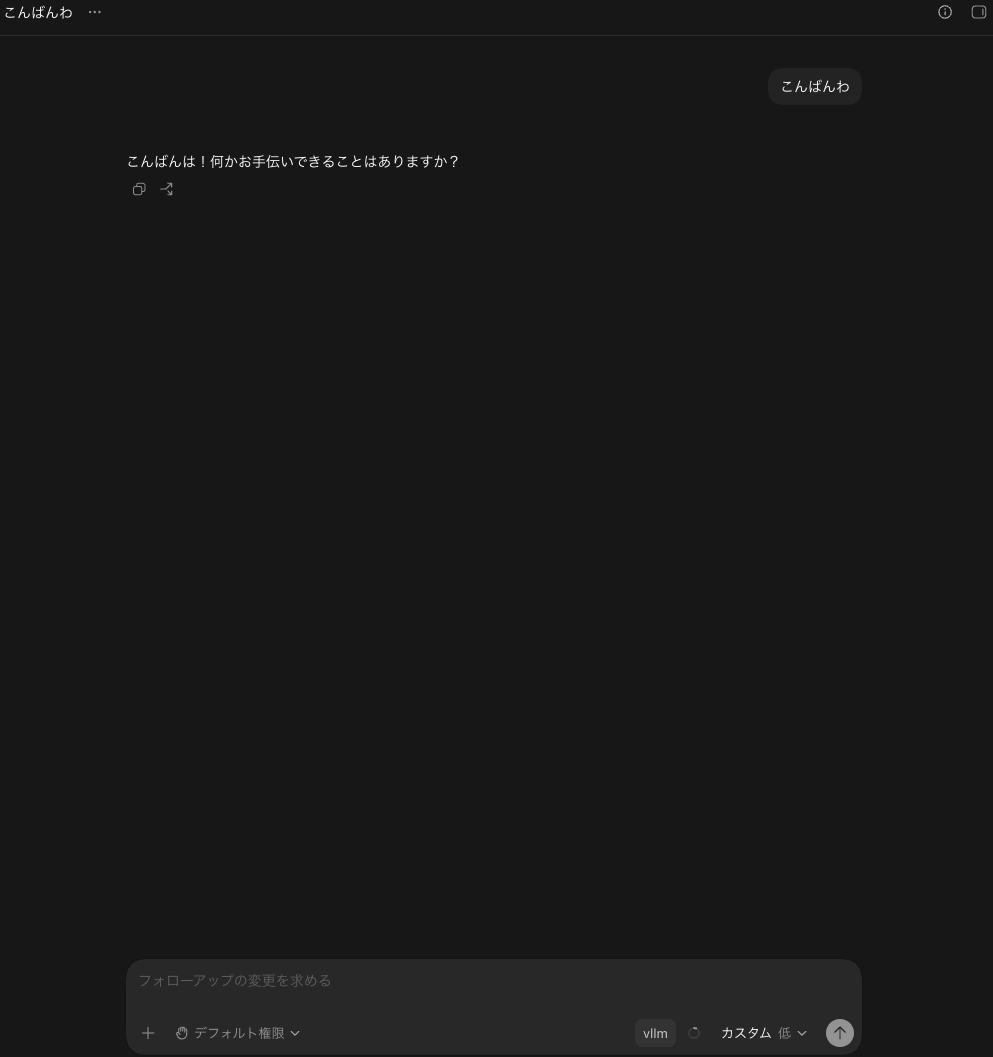
vllm側のログをみてると、なんか初回に「以前に設定していたモデル名」もしくは「GPT-5.4-Mini」で/v1/responsesにPOSTしようとして失敗するという挙動が入るが謎。ひとまず実害はない。
雑感
そんなこんなで、倍速化したGemma4:31bでのVibeCoding等を行うことができる。
素の31bでは待ち時間が長すぎて人間が適時レスポンスを要することを加味するととても実用には耐えなかったが、こちらは今のところゆっくりではあるが「まあ待てるかな」というラインで動いてくれてる感触。
